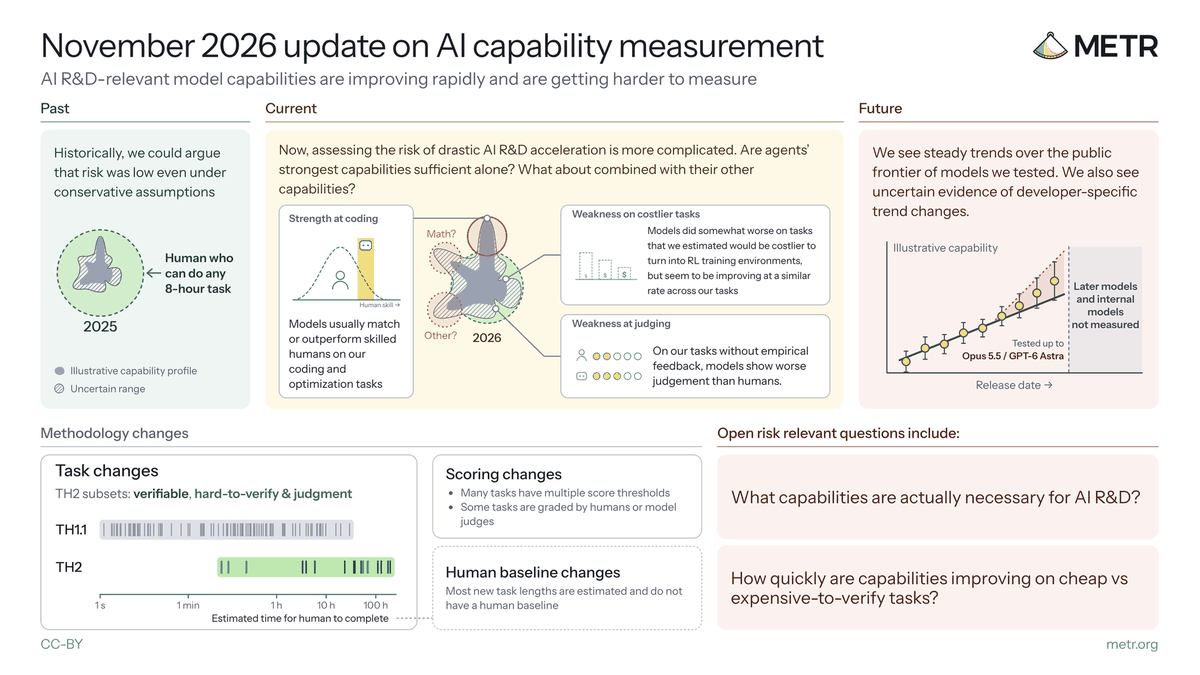
El informe de METR publicado el 20 de noviembre de 2026 examina capacidades relevantes para investigar y desarrollar IA. Plantea una escena incómoda: las máquinas cambian y las herramientas para medirlas necesitan cambiar también.
El dato que más fácilmente puede convertirse en titular es una duplicación del horizonte de tareas aproximadamente cada 3,6 meses en la combinación de las baterías TH1.1 y TH2. Sin embargo, convertir esa cifra en un calendario para sustituir empleos o en una cuenta atrás hacia una autonomía general exigiría conclusiones que la medición, por sí sola, no establece.
La actualización de noviembre y sus límites
El trabajo publicado por METR reúne evaluaciones de modelos públicos hasta Claude Opus 5.5 y GPT-6 Astra. Además del crecimiento medido, señala una dificultad importante: en tareas que requieren juicio sin una respuesta empírica clara, los agentes parecen rendir peor que expertos humanos. La calidad del criterio sigue siendo una pregunta distinta del éxito en una prueba con solución verificable.
Su índice compuesto no muestra una aceleración o desaceleración fuerte de la frontera pública examinada; algunas señales por desarrollador son metodológicamente sensibles. METR mantiene incertidumbre sobre las capacidades necesarias para acelerar drásticamente la investigación.
Estos resultados pueden convivir. Una tendencia sobre horizontes de tareas y otra sobre un índice compuesto responden a preguntas diferentes. Presentarlas como una contradicción inmediata sería tan engañoso como escoger únicamente la que mejor encaja con una predicción favorita.
La noticia, por tanto, incluye una advertencia sobre nuestra forma de leer el progreso. Una cifra permite observar una dimensión del cambio. Para comprender lo que significa, hay que conservar las condiciones bajo las que se obtuvo y las preguntas que deja abiertas.
Qué mide un horizonte de tareas
La explicación metodológica de METR define el horizonte como la duración de una tarea, medida según el tiempo humano de referencia, para la que se predice un determinado nivel de éxito del agente. Un horizonte al 50% indica la dificultad temporal donde el modelo ajustado estima éxito la mitad de las veces.
No se trata de cuánto tiempo permanece encendida la herramienta ni de la duración de una sesión automática. Si una tarea requiere varias horas humanas, el agente podría intentar resolverla en un tiempo diferente. La medida utiliza el tiempo humano como una aproximación a la dificultad dentro de un conjunto de tareas.
Ese conjunto se ha centrado principalmente en software, aprendizaje automático y ciberseguridad, con encargos delimitados y criterios evaluables. La página histórica de horizontes está fechada en septiembre y ya no se actualiza activamente; sirve para entender el método, no para sustituir los resultados de la publicación de noviembre.
La diferencia puede visualizarse con un encargo hipotético. Reparar un error descrito con precisión y entregar una modificación comprobable permite definir el éxito con relativa claridad. Decidir qué problema debe resolver una organización puede requerir conversaciones, prioridades y conocimiento de relaciones que no están presentes en esa prueba.
Una probabilidad de éxito no es una promesa de delegación
La nota de Thomas Kwa sobre las limitaciones del horizonte insiste en que la medida no permite concluir que todas las tareas más cortas puedan delegarse sin más. Algunas requieren probabilidades de éxito mucho mayores, y los fallos pueden exigir intervenciones complejas. El tiempo dedicado a preparar, esperar y comprobar resultados también cuenta al evaluar una mejora de productividad.
Esto ayuda a distinguir una capacidad experimental de una decisión operativa. Una herramienta puede ser útil incluso cuando necesita supervisión frecuente. Pero el valor de esa ayuda dependerá de cuánto trabajo evita y cuánto trabajo adicional genera alrededor de sus resultados.
Una evaluación propia podría registrar qué encargos se resuelven, cuáles requieren corrección y cuánto cuesta reconocer el error. También debería atender a las consecuencias de aceptar una respuesta equivocada. El mismo porcentaje puede resultar tolerable en un borrador exploratorio e insuficiente para una decisión que afecta a otras personas.
El criterio no debería reducirse a exigir perfección o aceptar cualquier avance. Se trata de elegir una combinación de tarea y supervisión que tenga sentido. Las medidas son más útiles cuando ayudan a diseñar esa combinación, en lugar de sustituirla por una promesa general.
Cambiar la prueba también cambia lo que observamos
En la actualización TH1.1 de enero de 2026, METR amplió su conjunto de 170 a 228 tareas y modificó otras para corregir problemas de descripción, evaluación o posibilidades de aprovechar la puntuación sin resolver bien el encargo. La organización explicó que la composición del conjunto podía alterar la tendencia estimada.
El antecedente resulta relevante para leer la actualización actual. Una evaluación necesita renovarse cuando las tareas dejan de distinguir capacidades. Al hacerlo, también debe explicar qué cambió y cómo afecta a la comparación. Mantener todo fijo puede empobrecer la medición; cambiarlo sin cuidado puede dificultar la interpretación.
Es una tensión habitual en cualquier instrumento que intenta seguir un fenómeno dinámico. Una regla no deja de ser útil por tener una escala limitada. El problema aparece cuando se usa fuera de ese rango y se olvida que la lectura ya depende de una extrapolación.
En IA, la popularidad de una clasificación puede hacer que ese matiz desaparezca. Un número recorre titulares y presentaciones mientras su protocolo queda atrás. Recuperar el protocolo permite entender si estamos observando una mejora del sistema, una diferencia de tareas o una combinación de ambas.
Las capacidades siguen siendo desiguales
Un análisis de METR sobre distintos dominios ya mostraba que los horizontes podían variar mucho entre tareas de razonamiento, programación y uso visual del ordenador. Sus autores advertían además de ruido en algunas estimaciones y de extrapolaciones fuera del rango observado. Ese estudio es un antecedente metodológico, no un retrato actualizado de cada modelo de noviembre.
La idea sigue siendo importante para formular preguntas. Una herramienta que escribe buen código no tiene por qué interpretar una interfaz con la misma fiabilidad. Del mismo modo, un resultado fuerte en preguntas científicas no describe automáticamente la capacidad para organizar un experimento real.
El trabajo cotidiano mezcla actividades de dificultad muy distinta. Hay pasos repetibles, momentos de ambigüedad y decisiones donde el resultado solo se conoce mucho después. Una cifra agregada puede orientarnos sobre una tendencia sin representar esa mezcla con suficiente detalle.
Por eso, hablar de «la capacidad de la IA» en singular suele ocultar parte del paisaje. Resulta más informativo preguntar qué sistema, con qué herramientas, en qué tipo de tarea y bajo qué criterio de éxito. La respuesta quizá sea menos espectacular, pero también permite actuar mejor.
El juicio necesita un lugar propio en la evaluación
El hallazgo sobre tareas con poca retroalimentación clara abre una conversación especialmente relevante. Cuando existe una prueba que devuelve un resultado rápido, un sistema puede intentar, corregir y volver a intentar. Cuando el criterio es incierto o las consecuencias aparecen más tarde, la evaluación necesita otras formas de evidencia.
Pensemos en un ejemplo hipotético: mejorar una función cuyo comportamiento puede comprobarse y elegir una dirección de investigación son encargos diferentes. El segundo puede exigir decidir qué merece atención antes de disponer de una señal definitiva de éxito. Una respuesta fluida no resuelve esa incertidumbre.
La supervisión humana tampoco debe idealizarse. Las personas pueden equivocarse o aceptar una explicación porque suena convincente. Precisamente por eso importa diseñar revisiones que permitan cuestionar el resultado, contrastar supuestos y reconocer cuándo la evidencia disponible es insuficiente.
Una colaboración útil podría repartir el trabajo de forma que las propuestas automáticas amplíen las opciones y las comprobaciones conserven un espacio independiente. El objetivo sería mejorar la calidad de la decisión, no acumular actividad alrededor de una conclusión que nadie ha puesto realmente a prueba.
Para comprobar una mejora, un equipo podría conservar ejemplos de encargos resueltos y fallidos, junto a los criterios que utilizó para revisarlos. Ese registro permitiría comparar una nueva versión con la anterior sin depender de una impresión reciente. También ayudaría a identificar si el cambio beneficia solo a las tareas más fáciles o alcanza los casos que consumen más atención.
La revisión tendría que incluir a quien recibe el resultado. Un documento que parece completo para quien lo genera puede seguir exigiendo trabajo a quien debe utilizarlo. Incorporar esa perspectiva permite valorar la utilidad en el recorrido entero del encargo. La calidad de la colaboración se observa mejor cuando se sigue la tarea hasta su uso efectivo.
Medir el cambio sin convertirlo en destino
El informe de METR ofrece evidencia para tomarse en serio el avance de los agentes de IA. También muestra por qué la evaluación de modelos necesita más de una medida y una lectura que preserve la incertidumbre. El crecimiento observado merece atención sin transformarse en una profecía detallada sobre todos los trabajos.
Para un equipo, la consecuencia práctica consiste en construir evidencia sobre sus propios encargos. Puede empezar por tareas acotadas, criterios explícitos y una revisión del tiempo total empleado. Si las condiciones cambian, la evaluación debería cambiar con ellas y dejar constancia de esa diferencia.
Para la conversación pública, el reto es sostener el interés sin simplificar el método hasta vaciarlo. «Cada 3,6 meses» describe una tendencia estimada en una combinación concreta de pruebas. Su significado depende de los modelos, las tareas y la forma de calcularla.
Quizá el indicador más importante de madurez sea aprender a mirar una curva y preguntar qué parte del mundo contiene. La IA puede estar cambiando deprisa. Nuestra capacidad para entender ese cambio necesita avanzar con ella, conservando un espacio para comprobar antes de concluir.
Imagen de portada: gráfico de METR para su actualización de capacidades de noviembre de 2026. Fuente: informe original enlazado en el artículo.