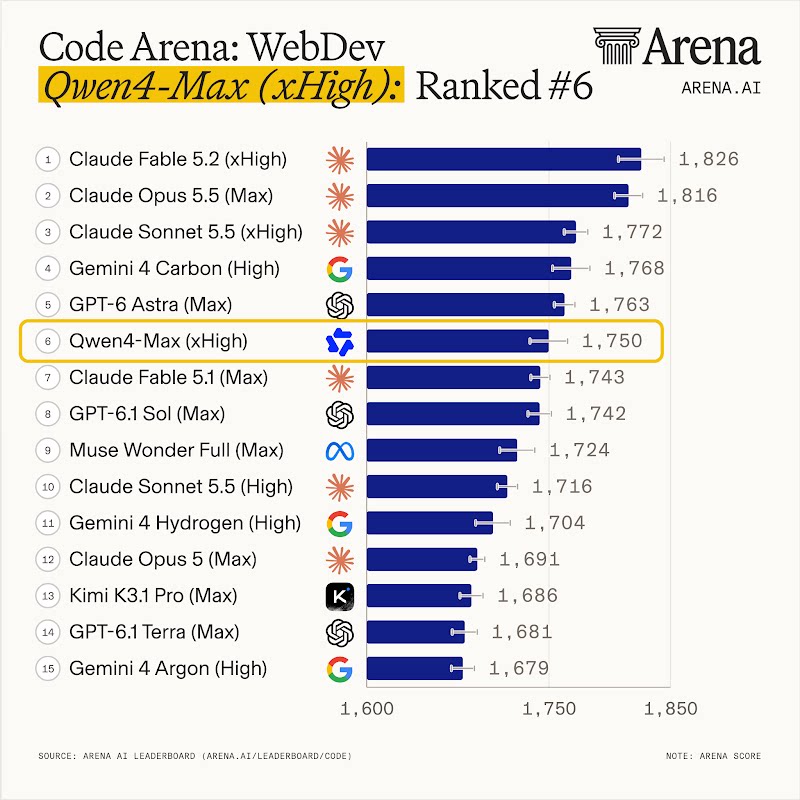
Qwen4-Max llega con una promesa que cambia la conversación: terminar el trabajo. Imagina que encargas una presentación y, en lugar de recibir consejos sobre cómo hacerla, encuentras los archivos preparados para revisarlos. Imagina después que el encargo se complica, aparecen errores y el sistema vuelve sobre sus pasos. La escena sirve para entender la ambición del nuevo modelo de Alibaba, presentado el 16 de noviembre de 2026 en su anuncio oficial.
La palabra decisiva es entregar. Porque entre una respuesta convincente y un resultado utilizable cabe un mundo: comprobar datos, abrir herramientas, corregir fallos y decidir cuándo algo está realmente acabado. Ese espacio, donde suelen esconderse las horas de trabajo, es el territorio que Alibaba quiere conquistar.
La pregunta que acompaña al lanzamiento resulta tan atractiva como incómoda: si una inteligencia artificial puede avanzar por nosotros durante horas, ¿cómo sabemos que está avanzando en la dirección correcta?
El salto que propone Qwen4-Max
Alibaba presenta su nuevo modelo como un compañero para el trabajo, la creación y la investigación. Bajo esa imagen comercial hay una apuesta concreta: combinar razonamiento, visión y ejecución prolongada con herramientas. El objetivo es encadenar acciones hasta producir algo que una persona pueda revisar y utilizar.
Conviene distinguir las piezas. El modelo interpreta instrucciones y propone acciones; las aplicaciones que lo integran le proporcionan acceso a programas, archivos o servicios. Sus posibilidades dependen de ese conjunto. Tener acceso a Qwen4-Max no significa disponer automáticamente de todas las demostraciones que aparecen en el lanzamiento.
El informe del equipo de Qwen describe proyectos que recorren varias etapas, desde la planificación hasta la comprobación del resultado. Ahí aparece el verdadero cambio de aspiración: pedir una explicación sobre un proceso y encargar que ese proceso se ejecute son dos maneras muy distintas de relacionarse con una máquina.
Para el usuario, la diferencia se puede formular sin jerga. Una cosa es recibir instrucciones para ordenar una carpeta caótica. Otra es recibir la carpeta ordenada, un índice y una explicación de las decisiones tomadas. El segundo encargo exige continuidad y deja muchas más oportunidades para equivocarse.
Un cerebro enorme que elige dónde concentrarse
La arquitectura Qwen4 utiliza una base de 2,4 billones de parámetros, con unos 71.000 millones activados por token, según la explicación técnica de Qwen. Su diseño de mezcla de expertos, conocido como MoE, permite utilizar partes del modelo en cada paso sin activar toda esa base a la vez.
La metáfora útil es una biblioteca con especialistas: disponer de muchas estanterías no obliga a consultarlas todas para resolver cada pregunta. Es una forma de aproximarse al diseño; esos especialistas son componentes matemáticos, sin voluntad ni comprensión humana.
El modelo incorpora además una ventana de contexto anunciada de un millón de tokens. Los tokens son las unidades con las que procesa la información. Esa capacidad amplía el material que puede manejar dentro de una interacción, algo relevante para encargos con documentos extensos y numerosas condiciones.
Pero una mesa más grande no garantiza que quien trabaja sobre ella encuentre siempre el papel correcto. Admitir mucho contexto y utilizarlo con precisión son capacidades que deben evaluarse por separado. Para una empresa, la prueba útil sigue siendo comprobar si el sistema encuentra el dato pertinente, conserva las restricciones y justifica el resultado.
Ver, razonar y actuar: las piezas de un mismo encargo
La documentación de Alibaba Cloud especifica entradas de texto, imagen y vídeo, con salida de texto. También recoge compatibilidad con búsqueda web, llamadas a herramientas y respuestas estructuradas. Es la base para conectar el modelo con flujos de trabajo que requieren algo más que conversar.
Esta precisión importa. Interpretar una imagen, generar un vídeo y manejar un programa de edición son funciones diferentes. Cuando una demostración reúne varias, hay que mirar el sistema completo: qué decide el modelo, qué ejecutan las herramientas y qué aporta el entorno preparado para la tarea.
Pensemos en un ejemplo hipotético de diseño. Una persona entrega un boceto y unas condiciones de espacio. El interés de una IA multimodal estaría en relacionar lo que ve con esas instrucciones, proponer cambios y comprobarlos mediante el programa correspondiente. El valor aparece cuando esas piezas se entienden entre sí.
La automatización del trabajo empieza a resultar interesante precisamente ahí, en las conexiones. También se vuelve más difícil de evaluar: una descripción elegante de lo que supuestamente se ha hecho no permite saber si los archivos funcionan o si una medida quedó mal interpretada.
Del estudio creativo al taller: qué muestran las demostraciones
El equipo de Qwen presenta ejemplos de uso de Blender para construir escenas, así como proyectos con Unity, Unreal Engine y Godot. Según su publicación, el modelo puede participar en la construcción del entorno, la lógica de juego y la revisión mediante pruebas. Son demostraciones del proveedor y conviene leerlas como tales.
Para un creador, lo sugerente es la posibilidad de explorar una idea antes de comprometer semanas de producción. Un prototipo permite descubrir que una mecánica aburre, una cámara desorienta o una escena necesita otra escala. La velocidad tiene valor cuando ayuda a formular mejores decisiones creativas.
Eso no elimina el oficio. Un proyecto que arranca puede seguir necesitando criterio visual, depuración y una dirección coherente. La facilidad para producir primeras versiones vuelve más importante saber distinguir entre una ocurrencia vistosa y una obra que merece desarrollarse.
La publicación también describe aplicaciones industriales que conectan planificación, diseño y verificación de mecanizado. Su interés está en cerrar un circuito: proponer, simular, detectar un problema y corregirlo antes de fabricar. Trasladar ese circuito a cada empresa requerirá comprobar sus condiciones, sus datos y sus límites operativos.
También aparece investigación molecular asistida por herramientas. En uno de los ejemplos vinculados al alzhéimer, el propio equipo indica que el candidato seleccionado necesita validación experimental adicional. Esa frontera merece permanecer visible: un resultado computacional prometedor constituye una etapa de investigación, sin demostrar por sí mismo eficacia clínica.
La productividad también se mide después de la respuesta
Alibaba acompaña el lanzamiento de Work360, una evaluación propia de tareas profesionales. En su nota de presentación afirma que Qwen4-Max reduce alrededor del 60 % el coste medio por tarea frente a Qwen3.8-Max en esa prueba. El dato describe una comparación concreta del proveedor; no anticipa el ahorro de cualquier negocio.
Es fácil enamorarse de un porcentaje. Más difícil es preguntarle qué incluye. ¿Cuenta los intentos fallidos? ¿La revisión? ¿El tiempo invertido en preparar la información? Un presupuesto real necesita contemplar el proceso que termina con un resultado aceptable.
La evaluación externa añade un matiz relevante. Artificial Analysis registra, en la consulta realizada para este artículo el 17 de noviembre, una puntuación de 43 en su índice de inteligencia y unos 32,1 minutos por tarea del índice. Su ficha describe un modelo relativamente lento en esa batería. Esas cifras pertenecen a sus pruebas y no equivalen al tiempo de cualquier consulta cotidiana.
La lectura práctica es sencilla: mayor capacidad, menor coste y rapidez no siempre avanzan al mismo ritmo. Un equipo que necesita respuestas inmediatas y otro que procesa encargos extensos durante la noche pueden valorar de forma muy distinta la misma tecnología.
Por eso, una comparación útil empezaría con varios trabajos reales y un criterio de aceptación escrito de antemano. Después habría que contar correcciones, gasto y tiempo humano. El indicador más honesto es el coste del trabajo que finalmente se puede dar por bueno.
Un agente que trabaja durante horas necesita ventanas abiertas
Los agentes de IA prolongan una pregunta delicada: ¿en qué momento supervisamos? Esperar al final de un encargo largo puede convertir una mala interpretación inicial en una montaña de decisiones equivocadas.
Qwen propone Live Delivery, una forma de entregar versiones utilizables mientras continúa el trabajo. Según su explicación, el usuario puede revisar avances e introducir correcciones durante la ejecución. El equipo también ha publicado un complemento de código abierto para este mecanismo, enlazado en su informe.
La idea conecta con una intuición muy humana. Cuando colaboramos con alguien en un proyecto complejo, rara vez esperamos al último día para comprobar si entendió el encargo. Compartimos borradores, acordamos hitos y corregimos el rumbo.
Aplicar ese criterio a la IA permite plantear preguntas concretas: qué ha producido, qué evidencia utilizó y qué falta por resolver. Una entrega intermedia sirve cuando ofrece algo comprobable. Un mensaje que asegura que todo progresa aporta mucha menos información.
Esta es la tensión del lanzamiento. Cuanto más trabajo delegamos, más necesitamos comprender las decisiones que tienen consecuencias. La autonomía útil requiere puntos de intervención y resultados que se puedan examinar.
Cómo acceder y qué significa realmente abierto
Qwen indica que Qwen4-Max está disponible en QwenCloud mediante API y Token Plan, además de integraciones en QwenWork, Qoder y QwenStudio. La disponibilidad práctica debe comprobarse en cada producto y cuenta; el anuncio reúne varias vías de acceso con condiciones que pueden diferir.
La documentación consultada sitúa la tarifa internacional de Singapur en 1,50 dólares por millón de tokens de entrada y 4,50 dólares por millón de salida. Son precios de API, con condiciones de región y facturación que conviene revisar antes de presupuestar. Una llamada puede consumir razonamiento además de la respuesta visible.
Hay otra distinción necesaria: en este lanzamiento, Qwen4-Max se ofrece como servicio propietario. La promesa de publicar modelos menores de la familia con pesos abiertos no convierte a Max en un modelo descargable. Tampoco la apertura del complemento Live Delivery equivale a abrir los pesos del modelo.
Para quien busca inteligencia artificial de Alibaba, esa diferencia afecta a decisiones muy prácticas: dónde se procesan los datos, qué infraestructura se necesita y cuánto control conserva la organización. La palabra abierto merece siempre una segunda pregunta: ¿qué parte, exactamente?
La próxima frontera será saber cuándo confiar
Qwen4-Max plantea una noticia relevante porque desplaza el foco hacia el resultado. El horizonte que dibuja combina herramientas, continuidad y entregas revisables. Su alcance real tendrá que demostrarse en tareas distintas de las escogidas para una presentación.
Para quienes trabajamos con conocimiento, la oportunidad es atractiva: dedicar menos energía a los pasos repetitivos y más a decidir qué merece hacerse. Pero ese reparto exige conservar el criterio que permite detectar una respuesta insuficiente, una fuente dudosa o un archivo que parece terminado y aún necesita trabajo.
El futuro que abre este lanzamiento tiene algo de taller con las luces encendidas de madrugada. La máquina sigue probando; nosotros debemos poder mirar dentro, cambiar el encargo y comprobar lo construido. Porque entregar más trabajo solo será un avance si también podemos responder de su calidad.
Imagen de portada: material gráfico del lanzamiento de Qwen4-Max publicado por Alibaba Cloud. Fuente: anuncio oficial enlazado en el artículo.