

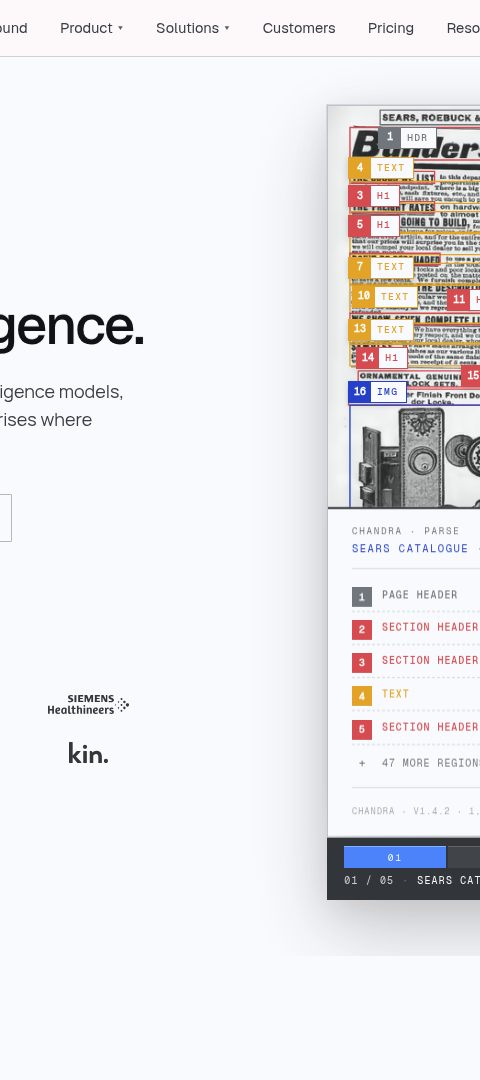
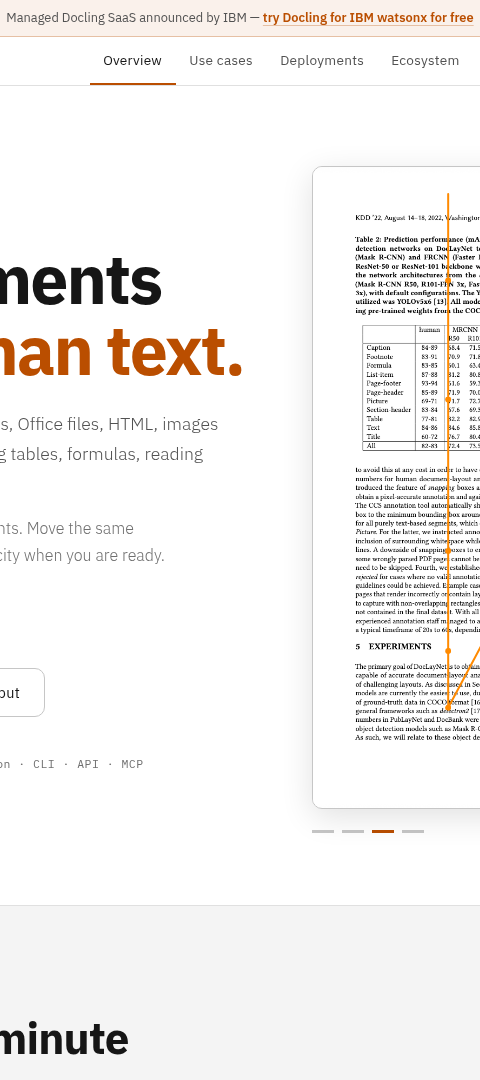
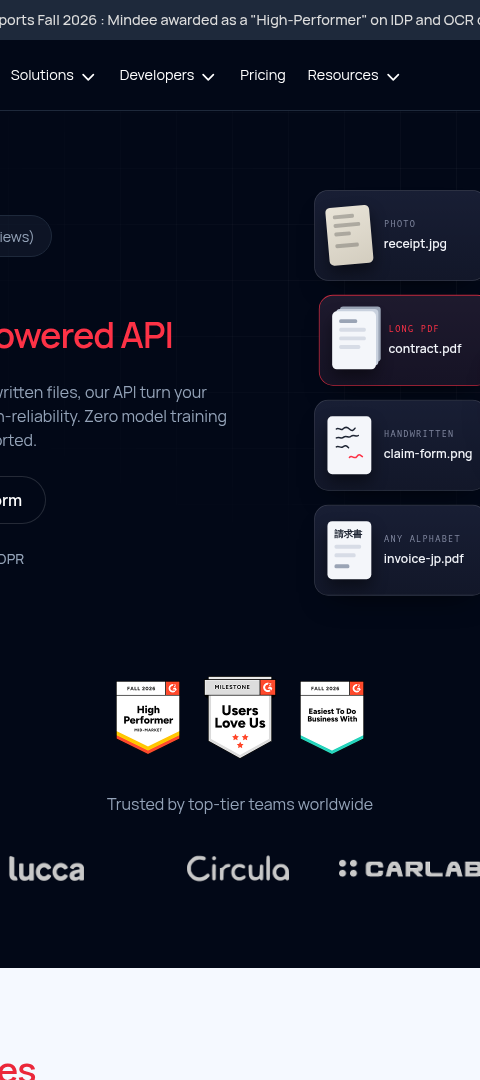
Nutrient ofrece una capa documental para aplicaciones y agentes de IA, junto con SDK y APIs de PDF. Su oferta incluye extracción de información, OCR, operaciones sobre documentos y conexiones MCP. La documentación describe referencias a la fuente y confianza de los datos extraídos, útiles para conservar trazabilidad. Puede encajar en productos que necesitan trabajar con documentos dentro de un proceso más amplio. Las capacidades varían entre SDK, APIs y productos, por lo que deben revisarse licencias, despliegue y volumen antes de contratar.
Funciones principales
- SDK y APIs para documentos y PDF.
- Extracción de datos con referencias a fuentes.
- OCR y conversión documental.
- Herramientas documentales para agentes.
- Conexión MCP e integraciones.
- Opciones de edición y automatización documental.
Para quién es y cómo empezar
Puede ayudar a equipos que convierten documentos en información aprovechable por otras aplicaciones. La calidad debe comprobarse con una muestra que incluya archivos claros, escaneos y formatos difíciles. Los campos críticos requieren revisión humana: extraer un dato correctamente no equivale a validar el contenido del documento.
Precio y condiciones
Consulta las condiciones vigentes en la web oficial: los límites de uso, las funciones incluidas y las modalidades de despliegue pueden variar. Esta ficha describe capacidades documentadas y no sustituye una prueba con tus propios datos.
Valoraciones y comentarios